Machine learning se tornou uma das tecnologias mais transformadoras da era digital. Ele está no centro dos sistemas de inteligência artificial e permite que o software vá além de regras estáticas, entrando em um comportamento adaptativo, preditivo e cada vez mais autônomo.
Buscadores usam machine learning para ordenar resultados. Bancos dependem dele para detectar fraude em milissegundos. Serviços de saúde aplicam a tecnologia para melhorar a precisão diagnóstica. Plataformas SaaS o embutem em copilotos de IA que ajudam o usuário em tempo real.
Para as organizações que constroem produtos com IA, machine learning faz parte da infraestrutura de base.
O que é machine learning
Machine learning é um ramo da inteligência artificial que permite a sistemas computacionais aprender com dados, reconhecer padrões e tomar decisões ou fazer previsões sem serem programados explicitamente para cada cenário.
O software tradicional segue instruções predefinidas, escritas por desenvolvedores. Sistemas de machine learning fazem o contrário: derivam a própria lógica interna analisando exemplos. Em vez de dizer ao sistema exatamente como resolver o problema, os desenvolvedores fornecem dados e um objetivo de otimização. O sistema aprende o mapeamento.
No fundo, machine learning transforma dados em capacidade de decisão. Essa passagem de uma lógica baseada em regras para um aprendizado guiado por dados é o que torna os sistemas modernos de IA adaptativos, escaláveis e capazes de melhorar continuamente.
Como o machine learning funciona
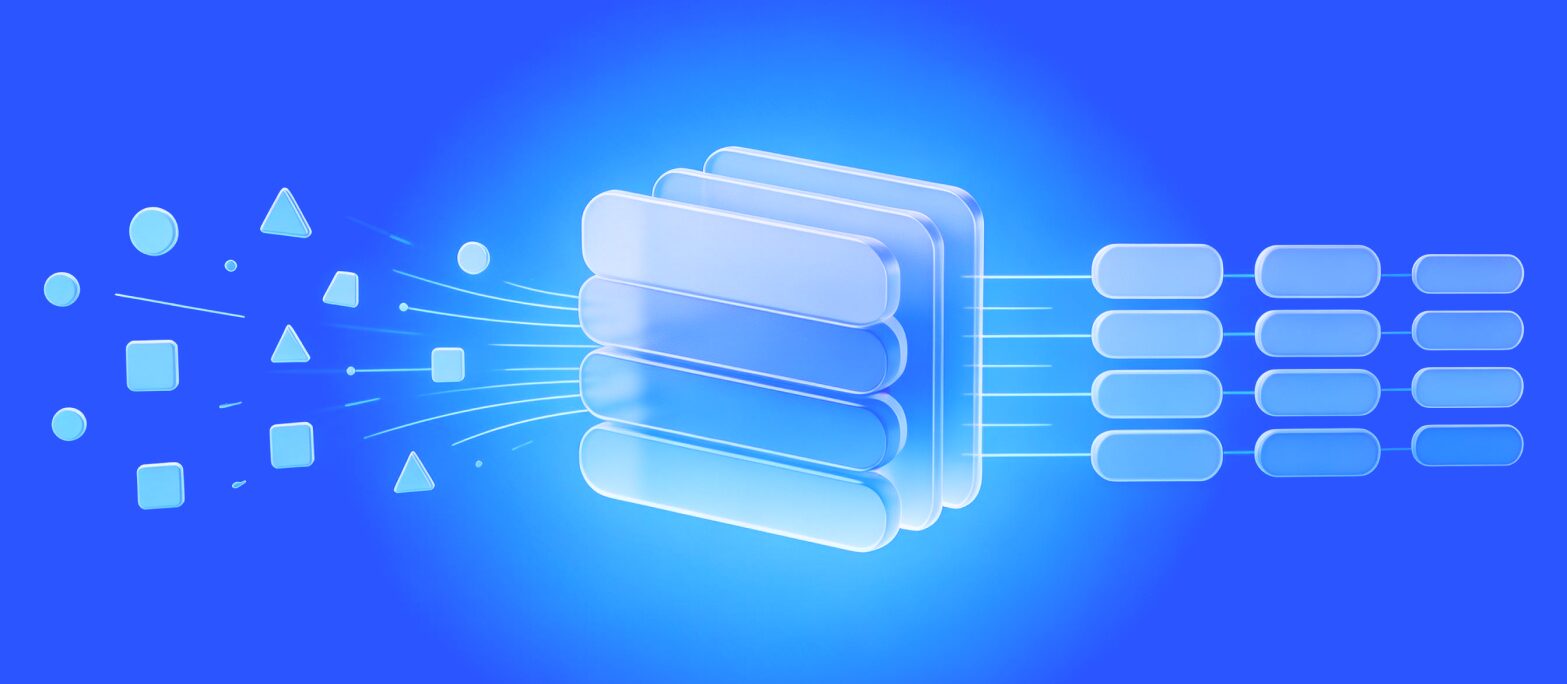
Sistemas de machine learning operam em um ciclo iterativo de ingestão de dados, treinamento, avaliação e refinamento. O princípio por trás disso é otimização estatística.
Um modelo começa como uma estrutura matemática com parâmetros ajustáveis. Durante o treinamento, ele analisa dados históricos e mede os erros de previsão. Com algoritmos de otimização, o modelo atualiza os próprios parâmetros internos para minimizar esses erros.
O desempenho melhora aos poucos, à medida que o sistema aprende os padrões embutidos nos dados.
Diferente de um código estático, o comportamento de um modelo de machine learning é moldado pela exposição à informação. Quanto mais representativos e de alta qualidade forem os dados, mais confiável fica o sistema.
Leia também: Glossário de IA e machine learning: termos-chave para empresas modernas
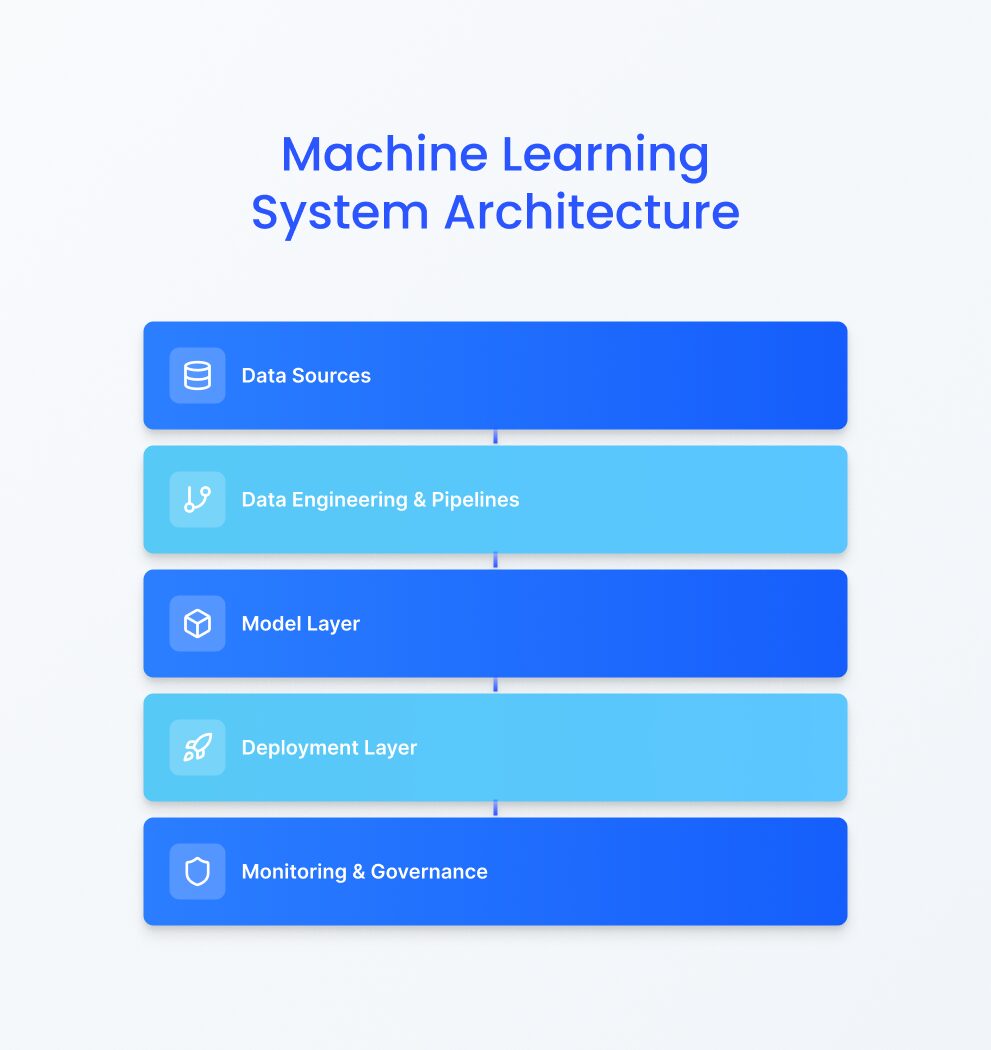
O ciclo de vida do machine learning
Dados como infraestrutura estratégica
Sistemas de machine learning valem exatamente o que valem os dados em que se apoiam. Organizações que tratam dados como subproduto da operação penam com iniciativas de IA. As que tratam dados como infraestrutura estratégica constroem vantagem competitiva sustentável.
Os dados precisam ser coletados de forma responsável, estruturados com consistência e governados com rigor. Privacidade, conformidade regulatória e restrições éticas não são preocupações secundárias: são requisitos de arquitetura.
Treinamento e desenvolvimento do modelo
Durante o treinamento, os algoritmos identificam relações entre entradas e saídas. Essas relações ficam codificadas nos parâmetros do modelo.
O desafio central é equilibrar complexidade. Modelos simples demais não capturam padrões relevantes. Modelos complexos demais podem memorizar os dados em vez de generalizar a partir deles. O objetivo é a generalização: ir bem em dados que o modelo nunca viu.
Essa tensão entre underfitting e overfitting define boa parte da engenharia prática de machine learning.
Avaliação e confiabilidade no mundo real
Testar o modelo em dados que ele nunca viu é essencial. As métricas de desempenho mudam conforme o problema: classificação, regressão, ranking ou recomendação.
Além das métricas estatísticas, os sistemas modernos de machine learning também precisam tratar justiça, viés, interpretabilidade e robustez. Em saúde, finanças e setores regulados, explicabilidade deixou de ser opcional.
Acurácia estatística:
- Acurácia
- Precisão
- Recall
- F1 score
- ROC-AUC
- Erro quadrático médio (para regressão)
Nesse nível, o que se mede é o desempenho do modelo nos dados de teste. Mas alta acurácia em um conjunto de dados controlado não garante sucesso no mundo real.
Confiabilidade operacional:
Aqui a lente é de engenharia. Confiabilidade operacional trata de:
- Latência (quão rápido as previsões são entregues)
- Escalabilidade (o sistema aguenta picos de tráfego?)
- Detecção de model drift
- Estabilidade da infraestrutura
- Monitoramento e observabilidade
- Sistemas de failover
Um modelo que funciona perfeitamente em um notebook pode falhar em produção por causa de:
- Mudanças na distribuição dos dados
- Sobrecarga de infraestrutura
- Timeouts de API
- Erros de pipeline
É aqui que MLOps se torna crítico. Juntas, essas dimensões definem o ML (machine learning) pronto para produção.
Garantia ética e de compliance
Sistemas modernos de ML influenciam aprovação de crédito, decisões médicas, processos de contratação e avaliações de risco financeiro. Isso traz restrições éticas e regulatórias.
As preocupações centrais são:
- Detecção e mitigação de viés
- Explicabilidade (interpretabilidade do modelo)
- Conformidade com privacidade de dados (GDPR, HIPAA, LGPD)
- Trilhas de auditoria
- Mecanismos de supervisão humana
Um modelo de alta acurácia ainda pode ser perigoso se:
- Discrimina grupos específicos
- Não consegue explicar as próprias decisões
- Viola regulações de privacidade de dados
Por que essas três dimensões precisam andar juntas
Muitas organizações otimizam apenas o desempenho estatístico. IA corporativa exige otimização nas três dimensões ao mesmo tempo:
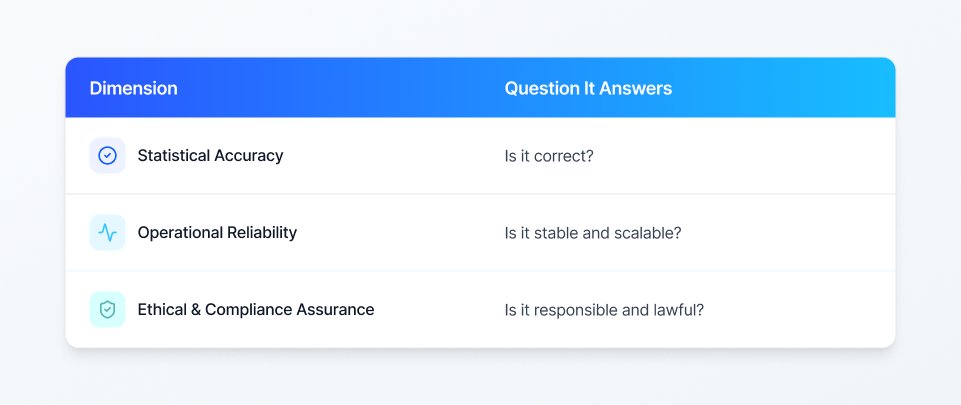
A interseção das três é o que gera machine learning pronto para produção e para o ambiente corporativo.
Deploy e aprendizado contínuo
Fazer o deploy de um modelo em produção o transforma de experimento em infraestrutura. Nesse estágio, escalabilidade, latência e eficiência de custo passam a ser críticas.
Com o tempo, as distribuições de dados do mundo real mudam. Esse fenômeno, conhecido como data drift ou concept drift, pode degradar o desempenho. Pipelines de monitoramento contínuo e retreinamento, o que costuma ser chamado de MLOps, garantem que os sistemas sigam precisos e alinhados aos objetivos de negócio.
Sistemas de machine learning não são ativos estáticos. São organismos em evolução dentro de um ecossistema digital.
Leia também: Casos de uso e aplicações de IA: como as empresas estão usando IA
Tipos de machine learning
As abordagens de machine learning variam conforme a estrutura do problema e a disponibilidade de dados rotulados.
Aprendizado supervisionado é a abordagem mais comum em sistemas corporativos. Ele depende de conjuntos de dados rotulados, em que os resultados históricos são conhecidos. O modelo aprende a prever resultados futuros a partir de exemplos passados. Essa técnica sustenta detecção de fraude, score de crédito, previsão de churn e projeção de receita.
Aprendizado não supervisionado faz o oposto: identifica padrões escondidos sem rótulos predefinidos. Ele revela clusters, anomalias e relações que nem sempre são óbvias. Isso é especialmente valioso em segmentação de clientes, análise comportamental e exploração inicial em data science.
Aprendizado semi-supervisionado combina as duas abordagens: o sistema aprende com um volume limitado de dados rotulados somado a grandes conjuntos não rotulados. Isso reduz o custo de rotulagem sem abrir mão do desempenho.
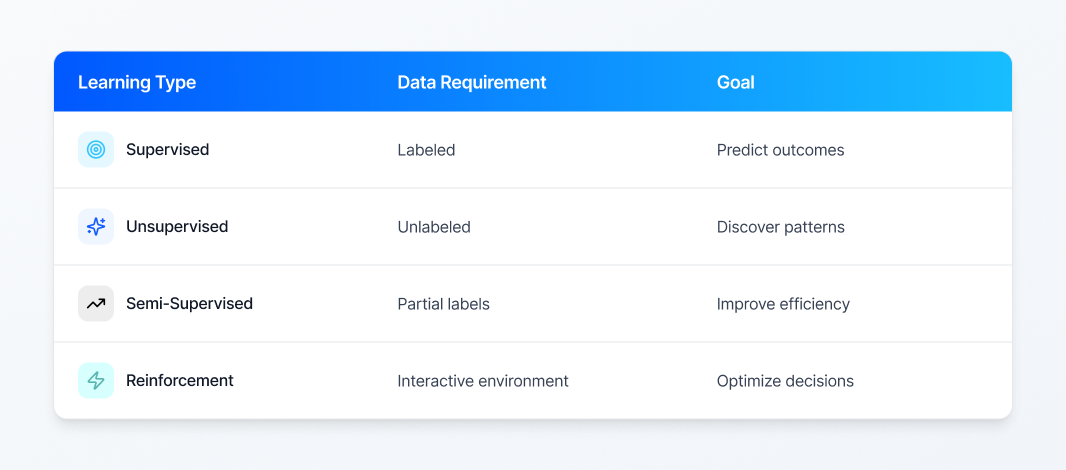
Aprendizado por reforço representa outro paradigma. Em vez de aprender com conjuntos de dados estáticos, o sistema interage com um ambiente e aprende por recompensas e penalidades. Essa abordagem costuma aparecer em robótica, sistemas autônomos e problemas de otimização dinâmica.
Machine learning vs deep learning
Deep learning é um subconjunto especializado de machine learning, construído sobre redes neurais de múltiplas camadas. Ele se destaca no processamento de dados complexos e de alta dimensionalidade, como imagens, voz e linguagem natural.
Enquanto o machine learning tradicional costuma depender de features construídas manualmente, o deep learning consegue aprender representações hierárquicas direto dos dados brutos.
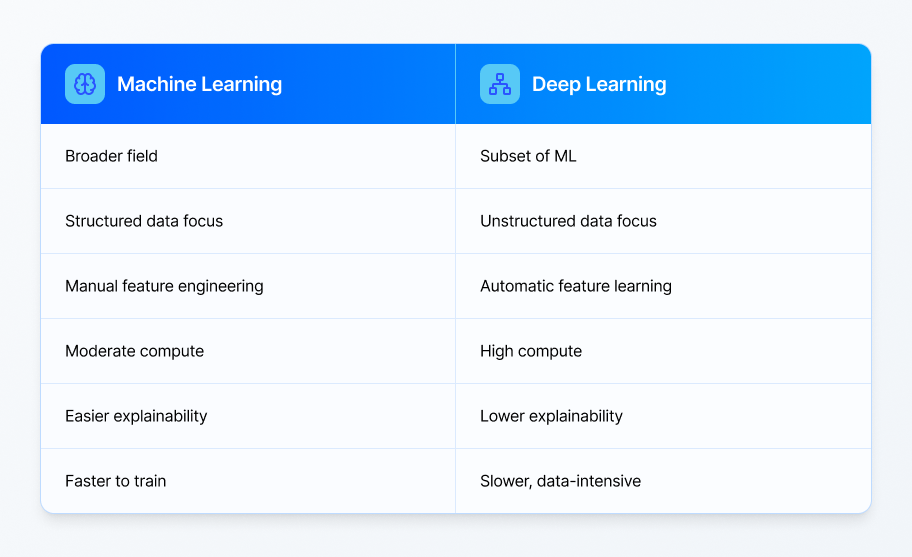
Grandes modelos de linguagem (LLMs), sistemas de visão computacional e motores de reconhecimento de fala são exemplos de aplicações de deep learning.
A distinção importa porque deep learning exige mais recursos computacionais e conjuntos de dados maiores. Em troca, viabiliza capacidades que antes eram inalcançáveis.
Machine learning nos negócios
Machine learning muda de forma profunda como as organizações operam.
Em finanças, permite detecção de fraude em tempo real e modelagem preditiva de risco. Em saúde, apoia a análise de imagens diagnósticas e a previsão de desfechos de pacientes. No varejo, move sistemas de recomendação e motores de precificação dinâmica. Em plataformas SaaS, melhora a experiência do usuário com automação inteligente e copilotos de IA.
Mais importante que isso: machine learning muda o paradigma de decisão. As organizações saem da análise descritiva e chegam à inteligência preditiva e prescritiva.
Essa mudança reduz incerteza, acelera a execução e destrava novas fontes de receita.
Descritivo → Diagnóstico → Preditivo → Prescritivo → Autônomo
Machine learning está no centro dessa progressão.
Estudo de caso: Knapsack Chat: integração de IA simples e segura para SaaS
Machine learning responsável e governança
À medida que os sistemas de machine learning influenciam decisões críticas, governança se torna essencial.
Mitigação de viés, transparência dos modelos, auditabilidade e arquitetura orientada a privacidade são hoje imperativos regulatórios e reputacionais.
Frameworks de IA responsável exigem:
- Linhagem de dados clara
- Documentação transparente dos modelos
- Monitoramento contínuo de viés
- Supervisão humana em decisões de alto impacto
Sistemas de ML de nível corporativo precisam integrar salvaguardas éticas direto na arquitetura.
Arquitetura de machine learning: do protótipo à produção
Muitas organizações constroem protótipos impressionantes que não escalam. Sistemas de machine learning prontos para produção exigem:
- Pipelines de dados distribuídos
- Deploy de modelos em containers
- Capacidade de inferência em tempo real
- Observabilidade e monitoramento
- Retreinamento automatizado
A diferença entre experimentação e infraestrutura está na maturidade operacional. Um diagrama de sistema que mostre pipelines de dados alimentando serviços de modelo, conectados a dashboards de monitoramento e a ciclos de retreinamento, torna essa arquitetura tangível para o leitor.
O futuro do machine learning
Machine learning converge cada vez mais com IA generativa, agents autônomos e análise em tempo real.
Os sistemas do futuro não vão apenas prever resultados. Vão gerar conteúdo, raciocinar em tarefas de múltiplas etapas e executar workflows de forma autônoma, dentro de limites definidos.
Além disso, a próxima geração de produtos digitais vai embutir machine learning como capacidade central, permitindo adaptação contínua ao comportamento do usuário e às mudanças do ambiente. As organizações que investirem hoje em arquitetura de ML escalável vão definir os sistemas inteligentes de amanhã.
Para fechar: o que muda com machine learning
Machine learning não é apenas uma tecnologia. É uma transformação estrutural na forma como o software é projetado e como as organizações tomam decisões. Isso exige rigor técnico, disciplina de arquitetura, governança de dados e alinhamento estratégico.
Quando é implementado com critério, machine learning se torna mais do que uma ferramenta de previsão: vira a espinha dorsal de produtos digitais inteligentes, adaptativos e escaláveis.
Na Cheesecake Labs, ajudamos empresas a projetar, construir e escalar sistemas de machine learning seguros, em conformidade e prontos para a complexidade do mundo real. Confira nosso portfólio aqui!
Se você está pronto para ir além da experimentação e construir sistemas de machine learning com impacto de negócio mensurável, nosso time está pronto para trabalhar com você. Vamos construir sistemas inteligentes que escalam!