Empresas que integram soluções de IA na operação costumam esbarrar em um dilema estratégico:
Investir em um modelo altamente especializado com fine-tuning ou apostar na flexibilidade do retrieval-augmented generation (RAG) para acessar informação dinâmica.
Cada abordagem tem vantagens e desafios próprios, e escolher errado custa recurso desperdiçado ou desempenho abaixo do necessário.
O que é fine-tuning?
Fine-tuning é treinar um modelo pré-treinado em um dataset especializado para adaptá-lo a uma tarefa ou a um domínio específico.
Esse processo grava o conhecimento do domínio direto nos parâmetros do modelo, o que permite a ele dominar a terminologia e os padrões de um nicho.

O que é RAG (Retrieval-Augmented Generation)?
O RAG melhora os modelos recuperando documentos relevantes de uma base de conhecimento externa durante a inferência. Isso permite que LLMs incorporem dados em tempo real ou específicos de um domínio sem precisar retreinar.

Detalhes de implementação técnica
Implementação de RAG
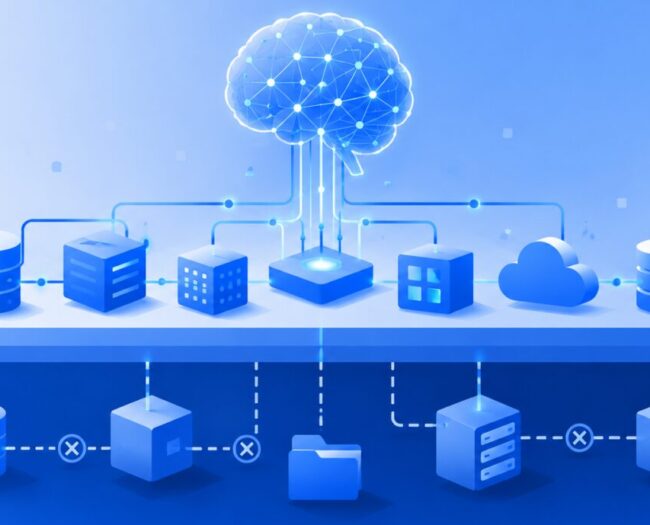
O RAG funciona convertendo documentos em vector embeddings, que capturam o significado semântico deles. Esses embeddings ficam armazenados em bancos vetoriais especializados como Pinecone, Weaviate ou Qdrant.
Quando chega uma consulta, ela também é convertida em embedding e usada para buscar documentos similares no banco. Os documentos recuperados entram como contexto para o LLM gerar a resposta.
Os componentes principais são:
- Pipeline de processamento de documentos: divide os documentos em chunks de tamanho adequado
- Modelo de embedding: transforma texto em vetores numéricos (por exemplo, o text-embedding-ada-002 da OpenAI)
- Banco vetorial: armazena os embeddings dos documentos e permite a busca semântica
- Mecanismo de recuperação: encontra os documentos relevantes por similaridade com a consulta
- Prompt engineering: estrutura como o conteúdo recuperado é apresentado ao LLM
Implementação de fine-tuning
O fine-tuning tradicional atualiza todos os parâmetros do modelo, o que sai caro em computação. As técnicas mais recentes de fine-tuning com eficiência de parâmetros reduzem bastante esse custo:
- LoRA (Low-Rank Adaptation): treina apenas um número pequeno de parâmetros de adaptação e mantém o modelo base congelado, o que reduz o custo de treinamento em até 90% sem perder desempenho.
- QLoRA: combina quantização com LoRA para ganhar ainda mais eficiência, o que viabiliza fine-tuning em hardware de consumo.
- PEFT (Parameter-Efficient Fine-Tuning): uma família de técnicas que inclui adapters, prefix tuning e prompt tuning.
Essas abordagens tornaram o fine-tuning mais acessível, mas ele continua exigindo dados de treino curados e conhecimento técnico.
Custo de tokens vs. custo de treinamento: a análise econômica
O trade-off econômico entre as duas abordagens pode ser visualizado assim:

Quando escolher fine-tuning e quando escolher RAG

Estágios da solução e escolha do método certo
- Prova de conceito (PoC): comece com RAG para validar mais rápido e com menos custo inicial.
- Produto mínimo viável (MVP): se o orçamento permitir, o fine-tuning entrega uma experiência mais refinada. Caso contrário, RAG continua sendo uma escolha forte.
- Startups: considere uma abordagem híbrida; comece com RAG e migre para fine-tuning conforme seus dados e seu orçamento crescem.
- Grandes empresas: dependendo da necessidade, dá para usar fine-tuning nas ferramentas internas e RAG nas aplicações voltadas ao cliente, que exigem informação atualizada.
Abordagem híbrida
Combinar RAG e fine-tuning parece atraente, mas costuma render menos do que se espera, porque os objetivos das duas técnicas conflitam. Se for tentar:
- Use fine-tuning para o conhecimento fundamental do domínio.
- Use RAG para as atualizações em tempo real.
- Teste com rigor: a integração nem sempre é tranquila.
Tendências atuais e caminhos futuros
À medida que os modelos crescem, de bilhões para trilhões de parâmetros, a vantagem de custo do RAG fica ainda maior.
O surgimento dos modelos multimodais, que lidam com texto, imagem e áudio, complica ainda mais o fine-tuning. O RAG se adapta com mais facilidade, porque basta incorporar diferentes tipos de mídia à base de conhecimento.
Modelos open-source estão tornando o fine-tuning mais acessível, enquanto a tecnologia de bancos vetoriais melhora rapidamente o desempenho dos sistemas de RAG.
Esses movimentos paralelos indicam que as duas abordagens vão continuar evoluindo, cada uma com seus casos de uso específicos.
Para fechar
Para as empresas, justificar o custo alto do fine-tuning, financeiro e operacional (cada atualização exige retreinar), fica cada vez mais difícil, na medida em que RAG e prompt engineering se firmam como alternativas escaláveis e mais baratas.
A eficiência de custo do RAG:
- O RAG dispensa o custo inicial de treinamento e reduz o esforço de manutenção, já que atualizar a base de conhecimento não exige retreinar o modelo.
- Estudos de Dodgson et al. (2023) mostram que RAG combinado com prompt engineering chega a cerca de 81% de acurácia em tarefas de recuperação de informação dinâmica, como análise financeira atual e eventos recentes. Na comparação com fine-tuning sobre datasets estáticos, as alucinações caem em torno de 80%.
Prompt engineering como alternativa de baixo custo:
- Prompts de sistema simples (por exemplo, “Você é um analista especialista…”) guiam o modelo a focar no contexto recuperado e melhoram a acurácia sem fine-tuning.
- Segundo Dodgson et al. (2023), prompts bem construídos reduzem as alucinações em cerca de 10% no GPT-3.5 base, chegando perto do desempenho de modelos com fine-tuning por uma fração do custo.
Quando o fine-tuning ainda se justifica:
- Domínios altamente regulados (por exemplo, saúde e direito): o fine-tuning garante aderência a uma terminologia estrita e reduz a dependência de dados externos.
- Aplicações offline: em sistemas isolados da rede (por exemplo, defesa e ferramentas on-premise), o fine-tuning continua essencial.
Ainda assim, para a maioria dos casos de uso corporativos (atendimento ao cliente, análise de mercado, bases de conhecimento internas), RAG com prompt engineering entrega desempenho comparável ao do fine-tuning e se alinha melhor às metas de orçamento e escalabilidade.
Para quem não é especialista, RAG com prompts de sistema (por exemplo, “Você é especialista em…”) oferece o melhor equilíbrio entre acurácia, custo e acessibilidade. O fine-tuning segue sendo uma ferramenta poderosa, mas de nicho, para customização profunda.
Referências:
- Soudani et al. (2024): Fine Tuning vs. Retrieval Augmented Generation for Less Popular Knowledge
- Ovadia et al. (2023): Fine-Tuning or Retrieval? Comparing Knowledge Injection in LLMs
- Lakatos et al. (2024): Investigating the Performance of Retrieval-Augmented Generation and Fine-Tuning for AI-Driven Knowledge Systems
- Dodgson et al. (2023): Establishing Performance Baselines in Fine-Tuning, Retrieval-Augmented Generation and System Prompting