Autoscaling é uma das promessas mais poderosas do Kubernetes e também uma das mais mal compreendidas. Muitos times ficam no autoscaling padrão, baseado em CPU ou memória, e só depois descobrem que o cluster não escala quando deveria, principalmente em workloads assíncronos (workers Celery, consumidores Kafka, serviços de ETL e afins).
Neste guia, você vai percorrer uma estratégia de autoscaling validada em produção que vai muito além das métricas básicas de recurso. Você vai aprender a combinar:
- Métricas customizadas da aplicação;
- Prometheus para o scraping;
- Prometheus Adapter para expor as métricas ao Kubernetes;
- Horizontal Pod Autoscalers (HPA) para escalar no nível dos pods;
- Node Autoscaler do AKS (ou de qualquer cloud) para escalar no nível da infraestrutura;
Essa é exatamente a arquitetura que usamos para escalar workloads baseados em Celery sob alta demanda, e ela se mostrou resiliente, previsível e eficiente em custo.
Se você constrói pipelines de busca, processadores em background, sistemas orientados a eventos ou serviços de inferência de IA, este tutorial entrega um blueprint definitivo de escala para Kubernetes.
Por que o autoscaling tradicional não dá conta
O autoscaling horizontal padrão do Kubernetes se apoia em CPU e memória. Em sistemas assíncronos ou orientados a fila, essas métricas não refletem a pressão real.
Um exemplo:
- Sua fila do Celery cresce de 200 → 6.000 tarefas;
- Os workers ficam totalmente ociosos entre uma tarefa e outra;
- A CPU fica entre 10% e 30%;
- O Kubernetes acha que está tudo bem.
Enquanto isso, os usuários esperam cada vez mais.
A verdade é esta: para fazer autoscaling do jeito certo, você precisa de métricas semânticas que descrevam a carga real, como profundidade da fila, utilização dos workers e lag de eventos. Neste tutorial, a escala é decidida pelo que realmente importa, não pelo que o kernel reporta.
Leia também: Migração cross-platform: por que ela funciona
Visão geral da arquitetura
O autoscaling vai seguir este fluxo:
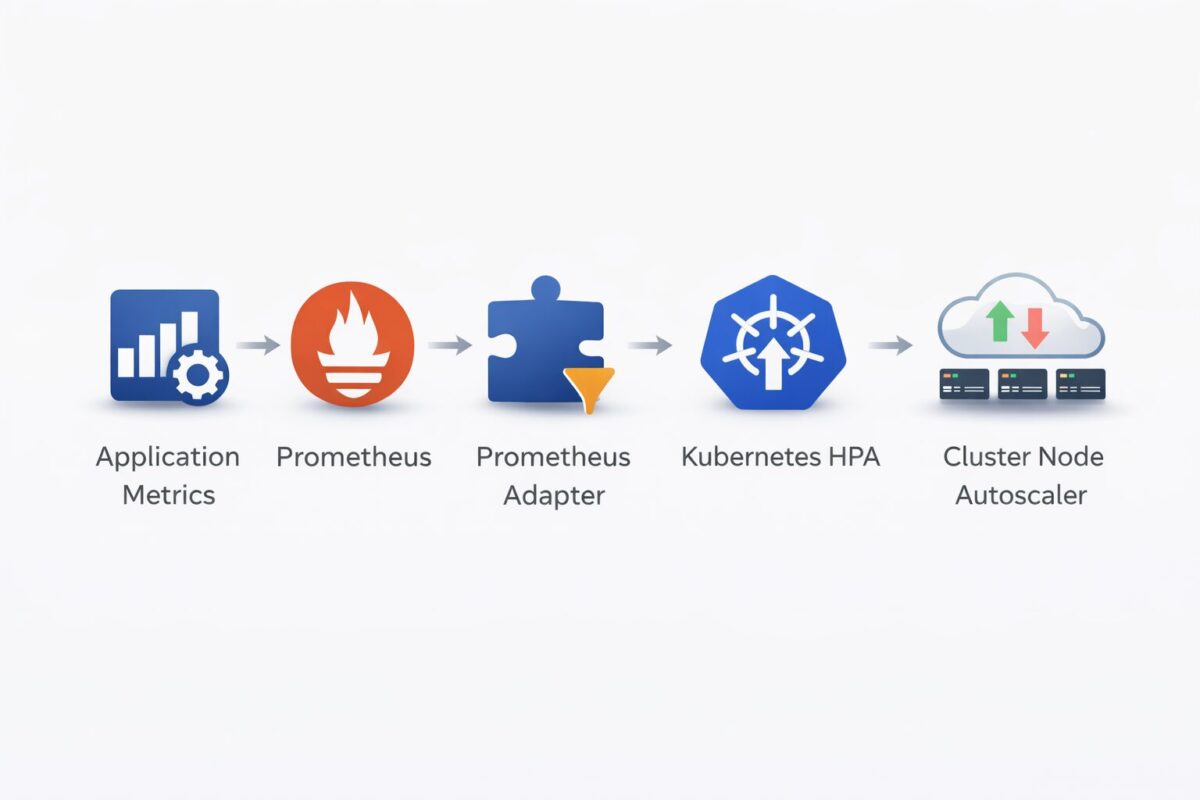
Vamos implementar cada camada, passo a passo.
1. Expondo métricas da aplicação, usando Celery como exemplo
Primeiro, exponha as métricas que o autoscaler vai usar.
Em Celery, normalmente publicamos:
- celery_queue_depth
- celery_workers_busy_ratio
Exemplo de estrutura do endpoint (no estilo Python/Flask):
@app.route("/metrics/celery")

def celery_metrics():

    queue_depth = get_queue_depth()

    busy_ratio = get_busy_workers_ratio()

    return f"""

    celery_queue_depth {queue_depth}

    celery_workers_busy_ratio {busy_ratio}

    """, 200, {"Content-Type": "text/plain"}Code language: PHP (php)
Exponha esse endpoint dentro do Kubernetes por meio de um Service:
apiVersion: v1

kind: Service

metadata:

  name: worker-metrics

spec:

  selector:

    app: my-worker

  ports:

    - name: metrics

      port: 8000

      targetPort: 8000Code language: HTTP (http)
2. Coletando métricas com o Prometheus
O Prometheus precisa fazer scraping do endpoint de métricas.
Adicione o seguinte ao values.yaml do seu Prometheus:
extraScrapeConfigs: |

  - job_name: 'worker-celery-metrics'

    metrics_path: /metrics/celery

    scrape_interval: 15s

    static_configs:

      - targets:

        - 'worker-metrics.default.svc.cluster.local:8000'Code language: JavaScript (javascript)
Assim o Prometheus coleta celery_queue_depth e celery_workers_busy_ratio a cada 15 segundos.
3. Expondo as métricas pelo Prometheus Adapter
Os Horizontal Pod Autoscalers do Kubernetes não conseguem consumir métricas do Prometheus diretamente. Para preencher essa lacuna, o Prometheus Adapter é instalado como um componente separado no cluster, normalmente pelo próprio Helm chart e por um arquivo de configuração, quase sempre em um namespace compartilhado como o monitoring.
O adapter se conecta ao Prometheus, executa queries predefinidas e expõe os resultados pela External Metrics API do Kubernetes (external.metrics.k8s.io). Essas regras de mapeamento de métricas ficam exclusivamente na configuração do Prometheus Adapter, e são elas que tornam as métricas customizadas da aplicação, como profundidade da fila do Celery ou utilização dos workers, disponíveis para o autoscaling.
Exemplo de configuração do adapter:
rules:

  external:

    - seriesQuery: 'celery_queue_depth{job="worker-celery-metrics"}'

      name:

        as: 'celery_queue_depth'

      metricsQuery: 'avg(celery_queue_depth)'

    - seriesQuery: 'celery_workers_busy_ratio{job="worker-celery-metrics"}'

      name:

        as: 'celery_workers_busy_ratio'

      metricsQuery: 'avg(celery_workers_busy_ratio)'Code language: JavaScript (javascript)
Depois do deploy, o Kubernetes consegue consultar essas métricas e os Horizontal Pod Autoscalers podem referenciá-las diretamente.
Você pode inspecioná-las com:
kubectl get --raw "/apis/external.metrics.k8s.io/v1beta1" | jq

You should see:

celery_queue_depth

celery_workers_busy_ratioCode language: JavaScript (javascript)
4. HPA do Kubernetes: escalando pods pela carga real
Com as métricas customizadas expostas pelo Prometheus Adapter, o Kubernetes passa a usá-las para decidir a escala. Isso acontece pelo Horizontal Pod Autoscaler (HPA), que ajusta o número de réplicas de pods pela pressão real da carga, e não apenas pelo uso de CPU ou memória.
Nesta configuração, o HPA escala os pods de worker usando métricas externas, como profundidade da fila e utilização dos workers. Essas métricas refletem quanto trabalho o sistema está de fato processando, o que deixa as decisões de escala mais precisas e mais responsivas.
Exemplo de configuração do HPA (usando Helm):
autoscaling:

  enabled: true

  minReplicas: 2

  maxReplicas: 10

  metrics:

    - type: External

      external:

        metric:

          name: celery_queue_depth

        target:

          type: AverageValue

          averageValue: "10"

    - type: External

      external:

        metric:

          name: celery_workers_busy_ratio

        target:

          type: AverageValue

          averageValue: "1"Code language: JavaScript (javascript)
Com essa configuração:
- Os pods escalam para cima quando a fila passa da profundidade alvo;
- Os pods escalam para cima quando os workers chegam perto da utilização total;
- Os pods escalam para baixo quando o sistema fica ocioso.
O ajuste do behavior do HPA e por que ele importa
Quando a escala é guiada por métricas externas ou pela carga, é importante configurar também os parâmetros de behavior do HPA. Sem eles, o autoscaler reage de forma agressiva demais a picos curtos de métrica, o que gera ciclos rápidos de subida e descida de réplicas (o chamado “flapping”).
Ao definir janelas de estabilização e políticas de escala, você garante decisões mais suaves, mais previsíveis e alinhadas a tendências sustentadas de carga, em vez de ruído passageiro.
Exemplo de configuração de behavior:
behavior:

  scaleUp:

    stabilizationWindowSeconds: 300

    policies:

      - type: Pods

        value: 1

        periodSeconds: 60

  scaleDown:

    stabilizationWindowSeconds: 300

    policies:

      - type: Pods

        value: 1

        periodSeconds: 60
Essa configuração limita a frequência com que réplicas podem ser adicionadas ou removidas e dá tempo para o sistema absorver as mudanças de demanda antes de novos ajustes. Em ambientes de produção, principalmente quando o autoscaling vem de métricas de fila, ajustar o behavior do HPA é essencial para evitar instabilidade e troca desnecessária de recursos.
Isso é autoscaling semântico: escala guiada pela lógica de negócio.
Leia também: Nearshore staff augmentation: um guia para o seu negócio
5. Autoscaling no nível dos nodes (AKS ou qualquer cloud provider)
O autoscaling de pods só funciona quando o cluster tem capacidade de compute suficiente. Para adicionar ou remover nodes automaticamente, é preciso habilitar um cluster autoscaler. Isso pode ser feito com a solução preferida da plataforma (o Cluster Autoscaler nativo do Kubernetes, o Karpenter ou um autoscaler gerenciado pelo cloud provider) e configurado por ferramentas de infraestrutura como código ou direto pelo console da cloud. Neste guia, o autoscaling de nodes é habilitado com Terraform, mas os mesmos conceitos valem para qualquer ferramenta ou implementação de autoscaler.
Exemplo genérico em Terraform:
resource "azurerm_kubernetes_cluster" "example" {

  name                = "autoscaling-cluster"

  location            = "eastus"

  resource_group_name = azurerm_resource_group.example.name

  dns_prefix          = "example"

  default_node_pool {

    name                = "default"

    vm_size             = "Standard_D4s_v3"

    node_count          = 2

    enable_auto_scaling = true

    min_count           = 1

    max_count           = 5

    mode                = "System"

  }

  identity {

    type = "SystemAssigned"

  }

}Code language: JavaScript (javascript)
Comportamento:
- Se os pods não puderem ser agendados → um novo node é adicionado;
- Se os nodes ficarem subutilizados → nodes são removidos;
Isso garante que:
- Seu HPA nunca fica travado;
- Você paga só pelo que usa;
Isso é essencial em qualquer sistema Kubernetes escalável em produção.
6. Validando a configuração
Verifique as decisões do HPA:
kubectl describe hpa -n defaultCode language: JavaScript (javascript)Verifique as métricas externas:
kubectl get --raw "/apis/external.metrics.k8s.io/v1beta1/namespaces/default/celery_queue_depth"Code language: JavaScript (javascript)Verifique os pods pendentes:
kubectl get pods -A | grep PendingCode language: JavaScript (javascript)Verifique as ações do autoscaler de nodes:
kubectl get nodes

kubectl describe node <name>Code language: HTML, XML (xml)
Para fechar: uma estratégia de autoscaling validada em produção
Fazer autoscaling no Kubernetes não é só ligar HPAs. Autoscaling de verdade exige métricas que entendem a aplicação, decisões bem calibradas e elasticidade de infraestrutura.
Ao combinar:
- Métricas customizadas
- Prometheus
- Prometheus Adapter
- HPA do Kubernetes
- Autoscaling de nodes
Você constrói um cluster que reage à demanda real, escala de forma suave sob pressão e reduz custo nos períodos ociosos.
Se suas aplicações dependem de filas, processamento em background ou qualquer workload assíncrono, essa estratégia de escala não é apenas desejável. Ela é essencial.
Este é o jeito definitivo de fazer autoscaling no Kubernetes.
Se o seu time de engenharia quiser ajuda para implementar esse padrão ou precisar escalar workloads mais avançados (IA, pipelines de busca, ETL e afins), entre em contato!